资料摘要:Luna-TTS
VUI Labs Research 提出的 diffusion-LLM TTS 家族:从 Qwen3-0.6B 逐步转换出完全并行的 Luna-TTS 与 block-causal streaming 的 Luna-TTS Realtime,直接在 RVQ 声学 token 网格上做 masked diffusion;两者共用 25Hz Luna-Codec、100 万小时四语种数据和 0.6B backbone 血统。
🔒 Luna-TTS Family Technical Report
- 不是把 diffusion 当 detokenizer:Luna-TTS 直接预测完整 acoustic RVQ 网格,codec decoder 只做确定、轻量的 token-to-waveform 映射;语言模型因此能直接拥有说话人、韵律与通道等声学信息。
- 同一模型家族的两个工作点:Luna-TTS 对整句 full-grid 做双向并行细化,面向离线吞吐、batch、editing;Realtime 只在 block 边界自回归,block 内仍并行去噪,面向增量交付。
- 25Hz、8 层 RVQ:Luna-Codec 将 24kHz 语音编码成 25Hz、、每码本 2048 项的网格,即 200 token/s、约 2.2 kbps;第一层 codebook 由 WavLM 蒸馏获得语义锚定。
- 渐进式适配:Qwen3-0.6B 的 causal attention 先改为 full bidirectional,训练成 Luna-TTS;再改为 two-stream block-causal mask,约 2 万步适配成 Realtime。tokenizer、embedding space、Transformer 与 prediction head 均保留。
- 表现力控制:utterance-level emotion token 控制整体情感,合成文本中的 inline NVV token 标记笑声、咳嗽、叹息等局部事件;说话人身份由 acoustic prompt 独立提供。
- 轨迹感知 GRPO:RL 不在虚构的左到右序列上算 ratio,而只对每轮去噪实际采样并提交的 token action 做 replay;WER 优先、speaker similarity 次级的 group-local ordinal reward 形成整句共享 advantage。
- 规模与范围:speech tokenizer 用 40 万小时训练;TTS pretraining corpus 约 100 万小时,普通话 43.4%、英文 43.1%、日文 6.7%、韩文 6.9%。
为什么 RVQ 网格适合 masked diffusion
Section titled “为什么 RVQ 网格适合 masked diffusion”目标语音表示为:
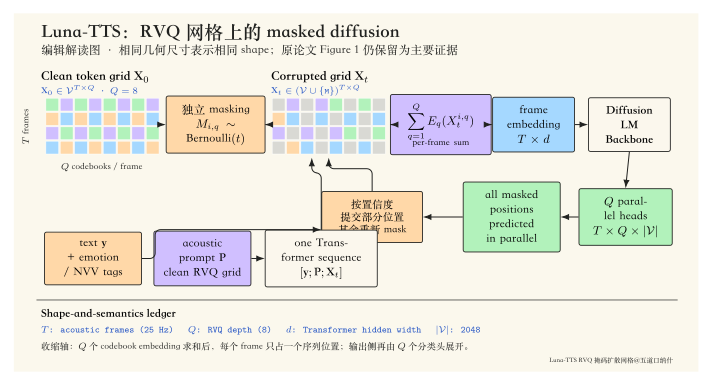
其中 是 acoustic frame 数, 是 codebook depth。时间轴有自然前后关系,但同一 frame 的 8 个 residual codebook 没有唯一正确的生成全序。AR codec LM 常用 delay pattern、depth-AR 或 MTP 给它人为安排次序;Luna-TTS 则让每个 以概率 独立变成 mask:
backbone 输入仍只有 个 frame position:每个 frame 的 个 codebook embedding 从独立表查出后相加,得到 ;输出侧再用 个并行 classification head 展开为 。这避免把序列长度扩成 。
Luna-TTS:整句 fully parallel
Section titled “Luna-TTS:整句 fully parallel”训练在完整 网格上不受限随机 masking。推理先由另一个 full-bidirectional Qwen3-0.6B duration predictor 预测每个 text token 的 quantized duration,再求和得到 ;随后从全 mask 网格出发,做 轮 confidence-based unmasking。每轮并行预测全部空位,按预测置信度与退火 Gumbel noise 提交一部分,其余重新 masking。
因为 acoustic prompt 只是同一网格中的干净区域,zero-shot voice cloning 可直接视为 infilling;mask 掉现有语音任意片段后在原始或修改文本条件下重新去噪,也自然形成 speech editing。代价是整句完成前不能输出音频,而且必须预先知道全局时长。
Luna-TTS Realtime:block 间 causal,block 内 diffusion
Section titled “Luna-TTS Realtime:block 间 causal,block 内 diffusion”Realtime 沿时间轴把网格切成 个 block:
分解只给 block 排序,不给 block 内 frame 或 codebook 排序。已完成 block 是不可变上下文,可写入 KV cache 并立即由 causal codec 解码;只有当前 block 可继续细化。论文默认 block 为 32 frame,即 1.28 秒。
| 维度 | Luna-TTS | Luna-TTS Realtime |
|---|---|---|
| attention | full bidirectional | block-causal |
| 长度 | 外部 duration predictor | learned EOS |
| 串行 NFE | 固定 | |
| KV cache | 否 | 是 |
| 流式输出 | 否 | 每 1.28 秒 block |
| 错误修正 | 全局迭代可改写 | 仅当前 block,提交后不可改 |
| 主要 workload | offline / batch / editing | streaming / interactive |
表现力数据与训练阶段
Section titled “表现力数据与训练阶段”数据生产分为标准化切分、转写对齐、质量与 cross-ASR 核验、组装与 Luna-Codec tokenization 四步。表现力子集将 source label 归一成 utterance-level emotion 与 text-aligned NVV event;Gemini 3.1 Pro Preview 等 audio-language model 提议并交叉检查标注,模型分歧、低置信度或复杂事件边界交由人工复核。
训练日程依次为:
- Foundation pretraining:Qwen3-0.6B 直接转换,完整多语言 mixture 约 100 万小时、约 100B packed speech–text token。
- High-quality annealing:约 10 万小时精选语音、约一个 epoch;不重启 learning rate,而沿原 cosine schedule 平滑衰减。
- Expressive continual pretraining:带 emotion / NVV 标注的数据混入少量 neutral speech,保持内容、音色与自然韵律。
- Block adaptation:从收敛 Luna-TTS 出发约 2 万个 optimization step,学习 block-causal streaming 与 termination。
RL:在实际 denoising trajectory 上更新
Section titled “RL:在实际 denoising trajectory 上更新”第 轮的状态、被选择位置和 token action 记作 。rollout 与 replay 都在 decoder 的有效采样 policy 下计算 probability,包括有效 token 约束、top-、temperature 和启用时的 CFG。对同一 prompt 采样至少两个候选,先以内容正确性、再以 speaker similarity 排序,形成 group-relative reward 与 standardized advantage。
token-level PPO-style clipped surrogate 避免对一整条并行轨迹的 ratio 连乘;per-utterance normalization 也防止长语句获得过大权重。局限是 reward 只有波形解码后才可观测,因此整条轨迹共享粗粒度 advantage,并没有 token-specific credit assignment。
Zero-shot 质量
Section titled “Zero-shot 质量”- Seed-TTS-Eval:Luna-TTS 的 test-zh 为 0.73 CER / 79.7 SIM,test-en 为 1.49 WER / 76.8 SIM,在报告表 8 的四列均最佳。
- CV3-Eval:普通话 CER 3.17、英文 WER 3.18,为报告表 9 最低;日文 5.00、韩文 5.93、四语言平均 4.32,则由 Qwen-Audio-3.0-TTS 的 4.78、4.30、4.17 领先。
- Realtime 质量代价:Seed-TTS-Eval test-zh / test-en 为 1.08 CER / 1.81 WER;CV3-Eval 四语言平均 4.95。hard-zh / hard-en 恶化到 12.56 / 13.98,明显高于离线 Luna-TTS 的 6.90 / 6.18。
Serving
Section titled “Serving”相同 Seed-TTS-Eval 中文请求、BF16、batch size 1、12 次预热运行中位数、不含网络:
| Profile | Steps | GPU / CFG | 首块 | 完整响应 | RTF |
|---|---|---|---|---|---|
| Luna-TTS | 16 | 1× H20,full-grid | 216.0 ms | 216.0 ms | 0.0211 |
| Realtime | 16 | 2× H20,parallel CFG | 63.8 ms | 451.4 ms | 0.0426 |
| Realtime | 8 | 2× H20,parallel CFG | 41.6 ms | 254.0 ms | 0.0240 |
41.6 ms 是本地 engine 从 invocation 到首个 1.28 秒 acoustic block 完成并解码的时间,不含 network transport,也不等于公网产品的用户侧 TTFB。
- NVV 客观指标:Luna-TTS 的 PCER 39.95%、recall 66.76%、F1 72.52%,均为四个系统最佳;precision 79.38% 并非最佳。
- NVV LALM 评分:整体 naturalness 3.65、quality 4.18、expression 3.75 最佳,但 NVV Accuracy 3.60 低于 MiniMax 的 3.95,NVV PE 3.63 略低于 ElevenLabs 的 3.75。
- emotion control:overall E-Sim 0.558、LALM Expression Quality 4.54、人工 E-MOS 3.90 最佳;Emotion Match 2.63 低于 MiniMax 的 2.70,N-MOS 4.14 低于 ElevenLabs 的 4.18。
- 基线协议不是全表统一:† 行由作者按同一官方 protocol 复评;⋄ 行直接引自各模型论文或已发布 comparison table,evaluation detail 可能不同。四列第一应理解为“在报告所列数据中第一”。
- 首块延迟绑定部署边界:41.6 ms 依赖双 H20、8-step parallel CFG、预热本地 engine,且排除网络;不能直接当作线上产品端到端首包承诺。
- streaming trade-off 在 hard case 放大:block 提交后不可撤销、Realtime 又用 learned EOS 而非 text-aware duration predictor,可能共同解释 noisy prompt 与不规则长文本上的明显差距。
- 对外复现材料仍有限:项目页目前提供论文、演示与样例,但报告中 100 万小时数据、训练 recipe、vLLM-Omni engine 配置和模型权重能否完整复现,需要以官方后续代码/权重发布为准。
- 四语种并非 massively multilingual:普通话与英文占约 86.5%,日文和韩文数据明显更少;韩文 CV3-Eval 也是四语种中最弱项。
- RL credit assignment 仍粗:trajectory-aware ratio 解决“该对哪些实际 action 算 ratio”,但没有解决 delayed utterance reward 如何归因到具体 token 与具体 denoising step。
- 神经音频编解码(RVQ) — Luna-Codec 的 25Hz、8-codebook 表示与 frame-wise embedding sum。
- 离散扩散模型(CTMC) — absorbing-state masked diffusion 与 any-order denoising 的背景。
- GRPO(组相对策略优化) — prompt-local group advantage 与 PPO-style clipped surrogate。
- CFG(无分类器引导) — 少步数解码与 RL effective policy 中的 guidance。
- 资料摘要:Qwen3-TTS — 12.5Hz/25Hz 自回归 codec LM 路线;也是本文初始化 backbone 与强基线之一。
- 资料摘要:MOSS-TTS — time–depth AR / local Transformer 处理 multi-codebook token 的对照路线。
- Wiki 目录