DEEP TECHNICAL COMPARISON · FULL-SONG MUSIC GENERATION

Tongyi vs. Qwen Music

同一条“语义 tokenizer → 自回归规划 → flow-matching 渲染”路线,两套系统却在码本、旋律表征、模型规模和整曲合成方式上作出了不同选择。

阅读主线:表示 → 旋律 → LLM → Decoder → 训练 → 数据 → 评测。

P1 · arXiv 2607.20253 ↗

Full-Song Generation: Hierarchical Autoregressive Planning Meets Flow-Matching Rendering

Alibaba Token Foundry · “Lucky Dolphin” Elo 1129

00

共同范式

总览

两者都采用离散语义 Tokenizer(25 Hz)→ 自回归 LLM → Flow/Diffusion DiT 渲染 → 48 kHz 立体声,并引入显式旋律规划、Cover 与偏好对齐。
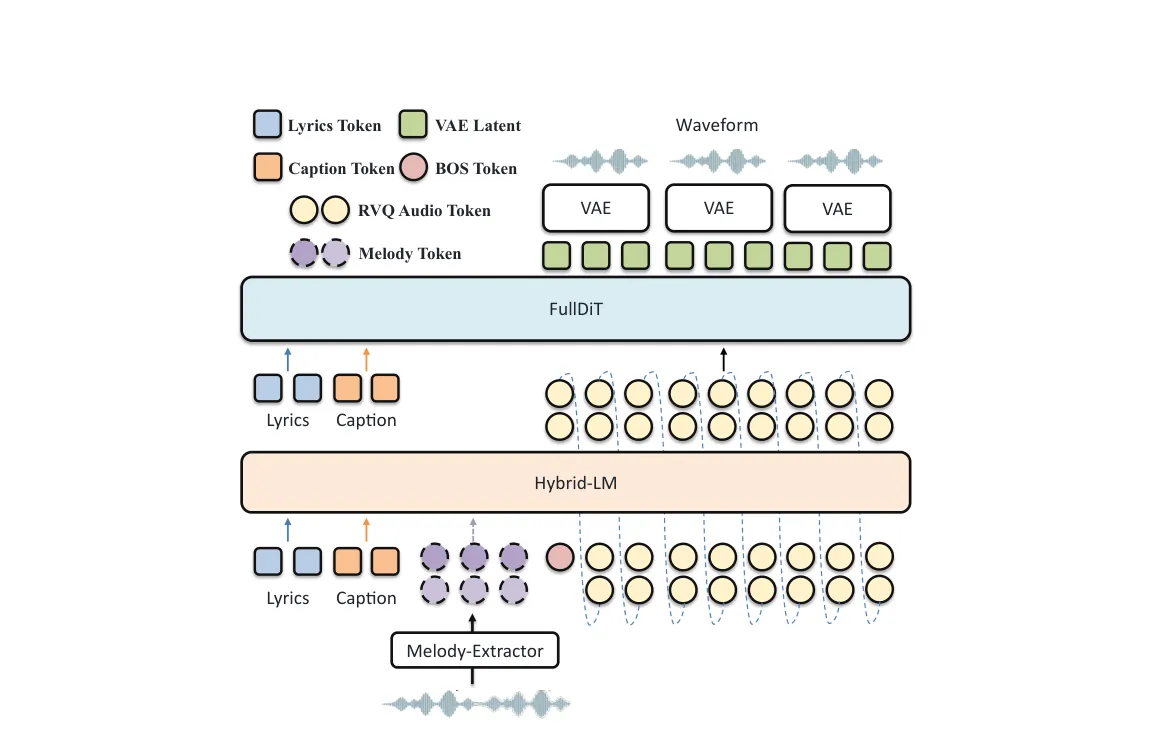
Full-Song 的 Hybrid-LM、FullDiT 与 VAE 整体架构
P1 · 总体框架Hybrid-LM 规划离散 token,FullDiT 在连续 latent 中完成整曲渲染。
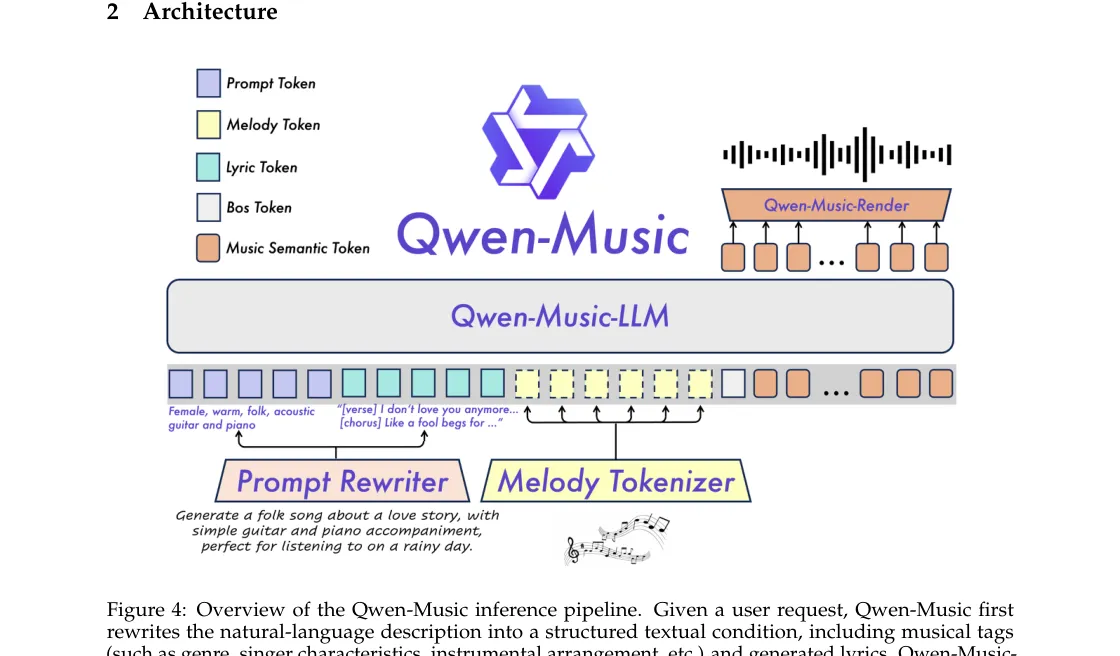
Qwen-Music 从提示词重写到 Render 解码的推理管线
P2 · 推理管线Prompt Rewriter、Melody-CoT、语义 token 与 Qwen-Music-Render 串成完整链路。
01

Key Ideas

四条原则一一对应

两篇报告都围绕分词、旋律、渲染和对齐展开;差异主要来自“保留多少音乐细节”与“把控制权放在哪一层”。

P1 · Full-Song

  1. 语义感知 RVQ 分词,配合分层自回归建模。
  2. FullDiT 整曲渲染,避免 chunk-wise 合成破坏全局一致性。
  3. 两级旋律建模,同时保留音符轮廓和演唱细节。
  4. DPO + GRPO,把后训练偏好对齐纳入生成链路。

P2 · Qwen-Music

  1. 25 Hz 单码本,形成紧凑的语义音乐空间。
  2. Melody-CoT,在生成语义 token 前显式规划旋律。
  3. 生成式声学渲染,DiT 后接 Spec-VAE 与 Band-Mode Refiner。
  4. 质量分级 scaling,配合多阶段偏好对齐。
02

任务侧重

支持能力并不完全重合

P1 多出“纯器乐生成”;P2 多出“一句话生曲”,由 Prompt Rewriter 自动补齐音乐 tags 与歌词。两家的 Cover 也分别强调“还原”和“改编”。

P1 · Full-Song(三任务)

  • Lyrics-to-Song:歌词 + 文本描述 + 音乐属性 → 完整歌曲。
  • Instrumental:无人声纯器乐,是 P1 独有的核心任务。
  • Cover:保留原旋律并更换风格,MIDI + F0F_0 双级旋律尽量还原演唱细节。
  • Caption 覆盖风格、情绪、乐器、演唱、段落结构与使用场景。
  • 论文自述器乐与翻唱的定量评测留作未来工作。

P2 · Qwen-Music(两任务)

  • Text-to-Music:一句自然语言即可,Prompt Rewriter 自动生成 tags 与歌词;也可由用户提供歌词。
  • Cover:旋律克隆后更换风格、音色、性别与调性。
  • 文本控制 genre、mood、乐器编排、人声音色和人声性别。
  • 5M+ 小时、多达数百种语言的训练数据带来多语泛化。
  • 以 Melody MAE 等指标评测 Cover,并与 Suno、MiniMax Cover 对比。
能力P1 · Full-SongP2 · Qwen-Music
词生曲 / 文生曲需提供歌词 + 描述一句话即可,自动写词 + tags
纯器乐独有核心任务未列为核心任务
Cover保旋律 + 演唱细节还原旋律克隆 + 换音色 / 性别 / 调
歌词自动生成外部输入Prompt Rewriter
控制维度风格、情绪、乐器、演唱、段落、场景genre、mood、乐器、音色、性别
多语言500 例多语基准数百语言,5M+ 小时
Cover 定量评测留作未来工作Melody MAE 等,优于所列对比系统

侧重总结:P1 的任务面更宽,Cover 追求绝对音高和演唱细节的“原汁原味”;P2 的使用门槛更低,Cover 只借旋律骨架,把风格、音色和编曲控制权交给文本。

03

System Scale

模块规模与规格速览

模块 / 规格P1 · Full-SongP2 · Qwen-Music
Tokenizer 编码器24 层 Conformer0.6B Conformer(24 层、width 1024、16 heads)
Codebook8 码本 × 8192单码本 × 32768(2152^{15}),375 bit/s
帧率25 Hz25 Hz(每 40 ms)
LLM全局 8B + 局部 0.4B(约 8.4B)3B Qwen3.5-Omni dense
Render DiTFullDiT 8B(消融另有 1.5B)1.3B DiT(32 层)
渲染隐空间连续 VAE latent → VAE 直出波形连续 latent(m=128m=128)→ Spec-VAE 复数 STFT → Refiner
MelodyMIDI 音符 + F0F_0 各 128 级,25 Hz 帧对齐RMVPE 50 Hz → 6.25 Hz 相对 MIDI,256 词表
整体量级8B + 0.4B + 8B0.6B + 3B + 1.3B

P1 走“大模型 + 多码本 + 整曲一次性”;P2 走“轻量单码本 + 频谱域后处理”。

04

Representation

Tokenizer · 表示、训练与 Loss

多码本 RVQ 与单码本超压缩走向不同,但训练配方高度同构:BEST-RQ 预训练 → 多任务微调 → 离散化。
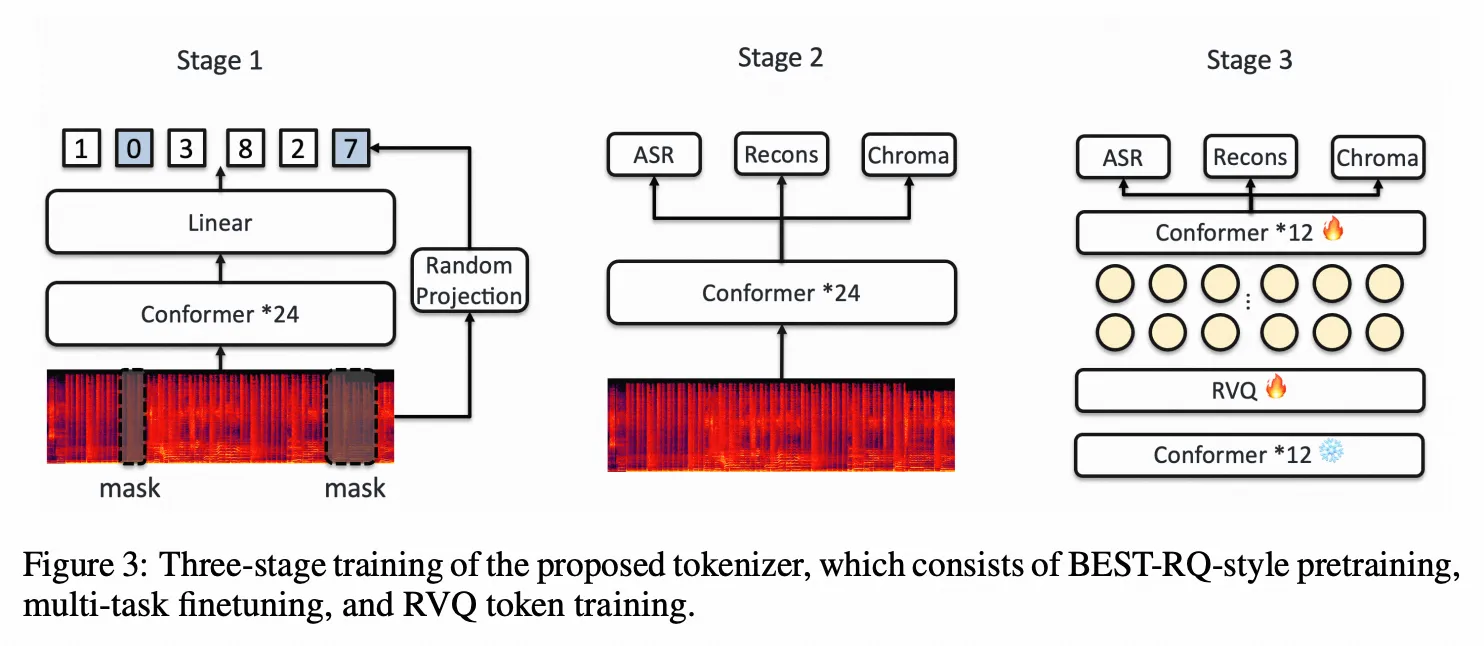
P1 · 多码本

  • 24 层 Conformer + 8 码本 RVQ,每本 8192,帧率 25 Hz。
  • c0c_0 承担主语义,另外 7 个残差码本补足声学细节。

P2 · 单码本

  • 0.6B Conformer + 单码本 VQ,词表 215=327682^{15}=32768,码率 375 bit/s,利用率超过 99%。
  • 单流多任务蒸馏同时承载语义、旋律 chroma 与歌词 CTC。
Full-Song tokenizer 三阶段训练流程图
P1 · Figure 3BEST-RQ 掩码预训练 → 多任务微调 → RVQ 量化。
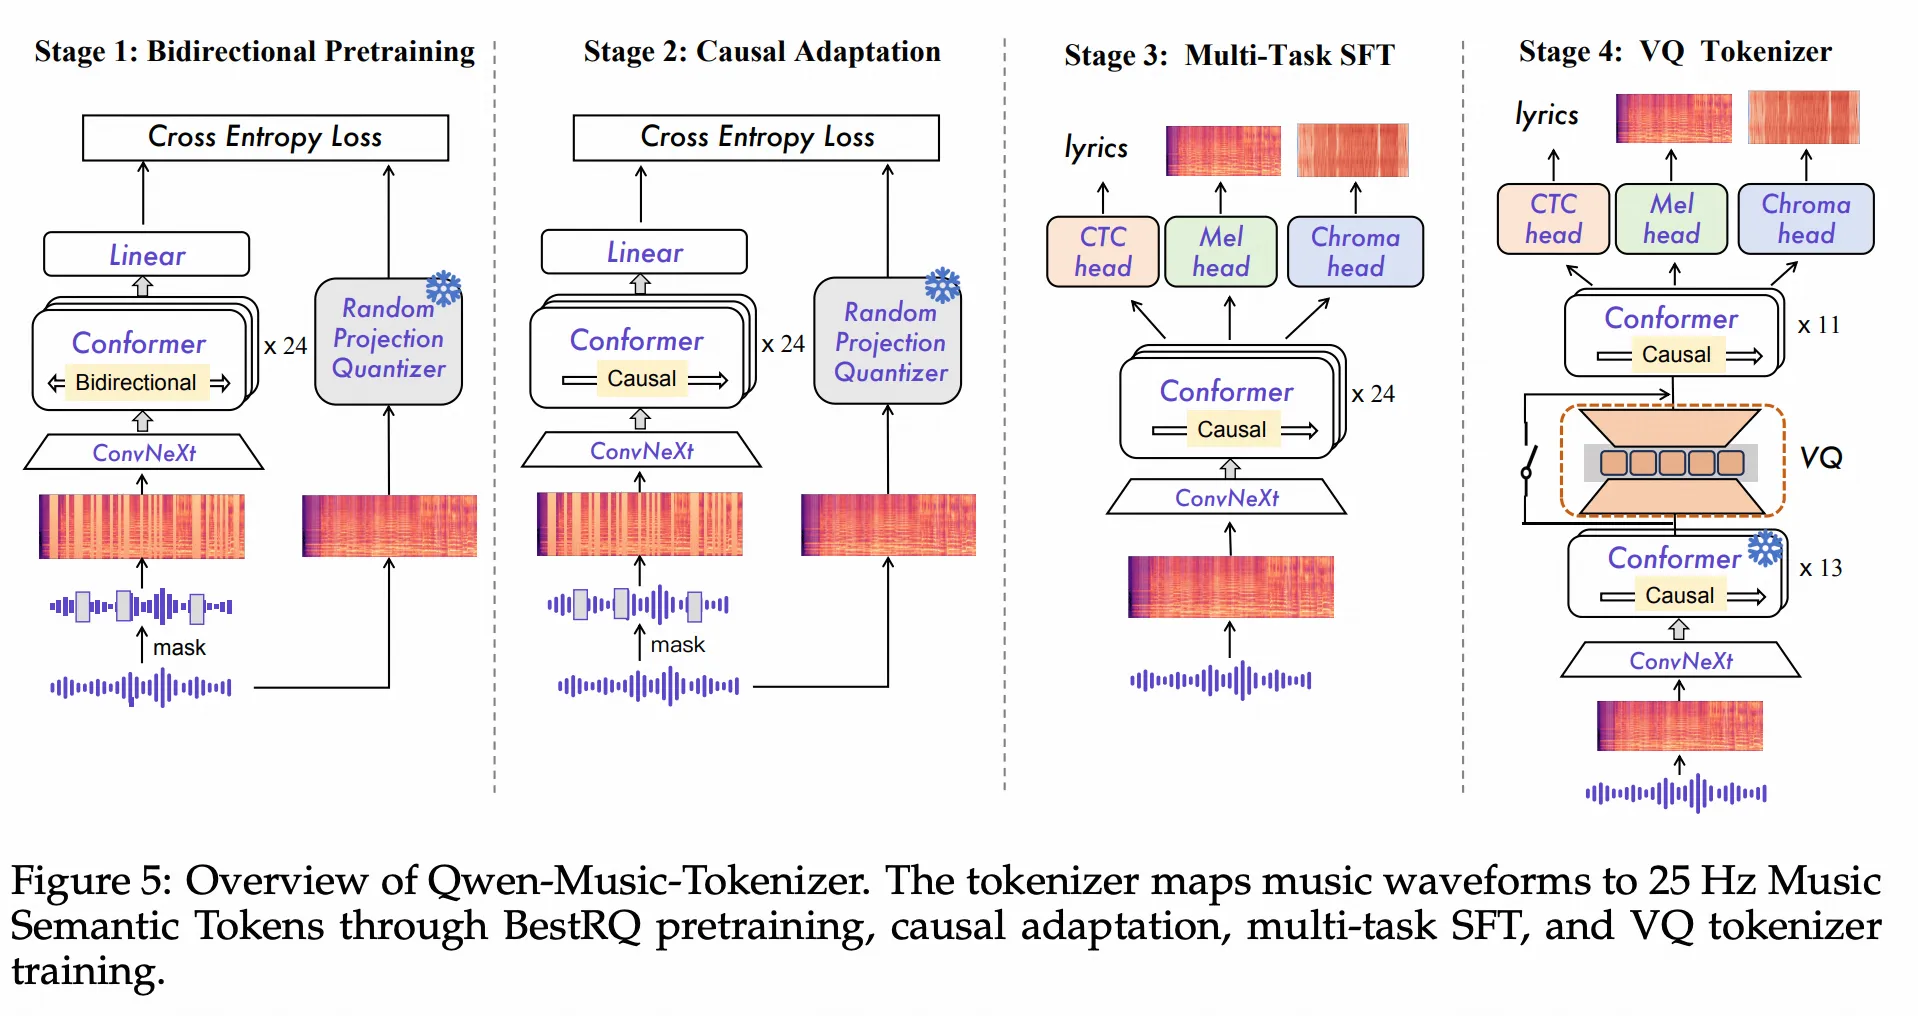
Qwen-Music tokenizer 四阶段训练流程图
P2 · Figure 5BestRQ 双向预训练 → 因果适配 → 多任务 SFT → 单码本 VQ。
阶段P1 · 三阶段P2 · 四阶段
预训练BEST-RQ 掩码,RPQ 目标BestRQ 双向掩码,CE
因果适配Causal Conformer + RPQ
多任务ASR + 重建 + chromaCTC 歌词 + Mel + chroma;全曲 ≤ 300 s
量化冻结底部 12 层,训练顶部 12 层 + 8 码本Straight-through + commitment
LossCE → 多任务 → RVQ + 重建LSFT=λctcLCTC+λmelLMel+λchrLchroma\mathcal{L}_{\mathrm{SFT}}=\lambda_{\mathrm{ctc}}\mathcal{L}_{\mathrm{CTC}}+\lambda_{\mathrm{mel}}\mathcal{L}_{\mathrm{Mel}}+\lambda_{\mathrm{chr}}\mathcal{L}_{\mathrm{chroma}}
05

Explicit Planning

Melody · 旋律 tokenizer 与建模

两者都从人声基频出发,把旋律离散成 token;真正差别是绝对 MIDI vs. 相对 MIDI、双粒度 vs. 单粒度、外挂条件 vs. CoT 规划

P1 · 两级绝对旋律 M=(MMIDI,MF0)M=(M_{\mathrm{MIDI}},M_{F_0})

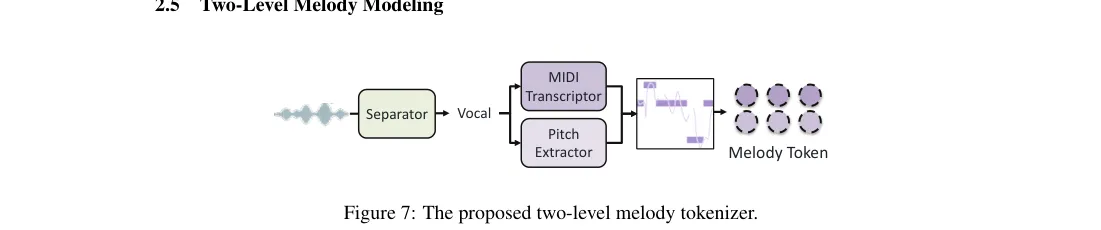
  • BS-RoFormer 从混音中分离人声轨。
  • MIDI 转录提供绝对音符序列,描述旋律轮廓。
  • 帧级 F0F_0 保留 vibrato、局部音高变化和演唱表现。
  • 两级表示与 25 Hz codec 帧对齐,作为 Hybrid-LM 外部条件。

P2 · 单级相对 MIDI

  • RMVPE 提取 50 Hz 基频,再以 8× 中值池化降到 6.25 Hz。
  • 减去全曲有声帧的 MIDI 中位数,只保留相对半音偏移。
  • 256 词表,其中 255 表示 unvoiced。
  • 原创由 LLM 在 Melody-CoT 中生成;Cover 则以前缀条件注入参考旋律。
维度P1 · 两级绝对P2 · 单级相对
人声提取BS-RoFormer 分离RMVPE 50 Hz 基频
MIDI 用法绝对 MIDI 音符减中位数后的相对 MIDI
粒度MIDI 音符 + 帧级 F0F_06.25 Hz 粗轮廓
演唱细节保留 vibrato 与表现中值池化后主动丢弃
绝对音高 / 调保留去除,register 无关
接入方式Hybrid-LM 外部条件Melody-CoT 规划 + 前缀条件
Full-Song 两级 melody tokenizer 的人声分离、MIDI 转录与 F0 提取流程
P1 · Figure 7人声分离后并行执行 MIDI 转录与帧级 pitch 提取,形成粗细两级 Melody Token。

旋律量化:从基频到 token

P1 · 25 Hz 双码本

  • MIDI 路把音符按时值沿时间轴重复展开,直接用 MIDI pitch ID 作为 128 级 token;0 留给非人声帧。
  • F0F_0 路先进入 log-pitch 域,再量化为 128 级、25 Hz token;0 同样表示非人声。
  • 两路并行输入 Hybrid-LM:MIDI 管全局轮廓,F0F_0 管局部音高与词音对齐。

P2 · 相对 MIDI 量化

f~=MedianPool8(f)\tilde f=\operatorname{MedianPool}_{8}(f)
mˉ=median ⁣{round(hz2midi(f~i))f~i>0}\bar m=\operatorname{median}\!\left\{\operatorname{round}(\operatorname{hz2midi}(\tilde f_i))\mid \tilde f_i>0\right\}
zi={clip(round(hz2midi(f~i))mˉ,127,127)+127,f~i>0255,unvoicedz_i=\begin{cases}\operatorname{clip}(\operatorname{round}(\operatorname{hz2midi}(\tilde f_i))-\bar m,-127,127)+127,&\tilde f_i>0\\255,&\text{unvoiced}\end{cases}

减去 mˉ\bar m 去掉音区与调性,低帧率则抹掉装饰音,最终只保留可迁移的旋律骨架。

Melody Tokenizer 与 Melody-CoT 的分工

Melody Tokenizer 是“读谱器”:把参考歌的人声旋律变成 6.25 Hz 的相对半音 token。Melody-CoT 是“用法”:规定这串 token 在 LLM 序列里由谁产生、放在哪一段。它不是音频,也不直接进入渲染器。

原创

tags + lyrics → LLM 自生成 melody plan → Music Semantic Tokens → Render

Cover

tags + lyrics + 参考旋律 token 前缀 → Music Semantic Tokens → Render

同:都基于人声基频、MIDI 与离散 token,并服务于 Cover。异:P1 力求同时还原旋律和演唱;P2 只保留旋律骨架,以换取更强的换调、换音色与风格改编能力。

06

Autoregressive Backbone

LLM · 分层建模与旋律规划

P1 · Hybrid-LM

  • HeartMuLa:8B 全局模型沿时间轴生成 c0c_0,0.4B 局部模型沿 RVQ 深度轴补齐另外 7 个码本。
  • 大规模预训练 → 风格均衡 mid-training → 高质量 SFT。

P2 · 单一 AR 骨干

  • 由 3B dense Qwen3.5-Omni 初始化。
  • Melody-CoT 先规划旋律再生成音乐语义 token;Prompt Rewriter 负责把自然语言整理为标签与歌词。
07

Flow-Matching Rendering

Decoder · FullDiT vs. Qwen-Music-Render

二者都用 flow-matching DiT,但 P1 以 8B 非因果模型一次性处理整曲,P2 以 1.3B DiT 生成 latent,再在频谱域做两段精修。
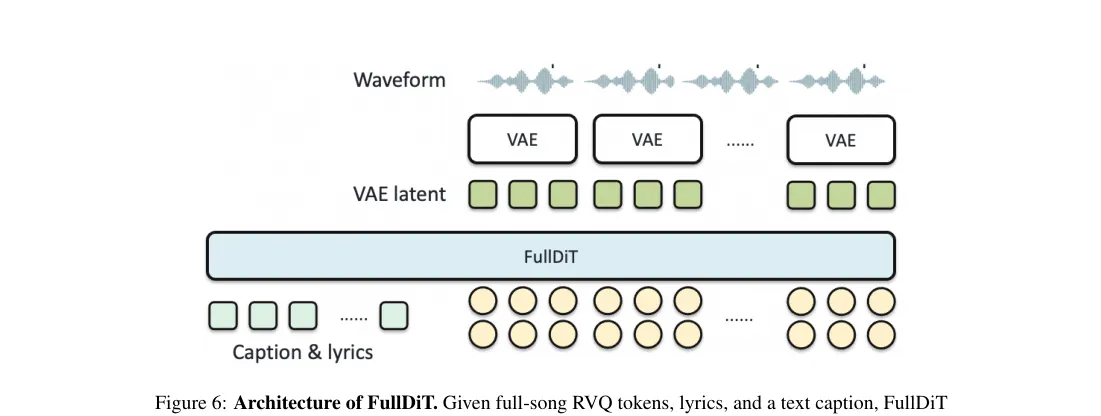
P1 · FullDiT

  • 8B 非因果整曲 flow matching,工作在连续 VAE latent 中。
  • Codec embedding 与音频帧对齐;歌词和 caption 直接参与 FullDiT 的全上下文注意力。
  • 固定 VAE 解码器直出 48 kHz 立体声,强调全局一致性。

P2 · DiT + 频谱精修

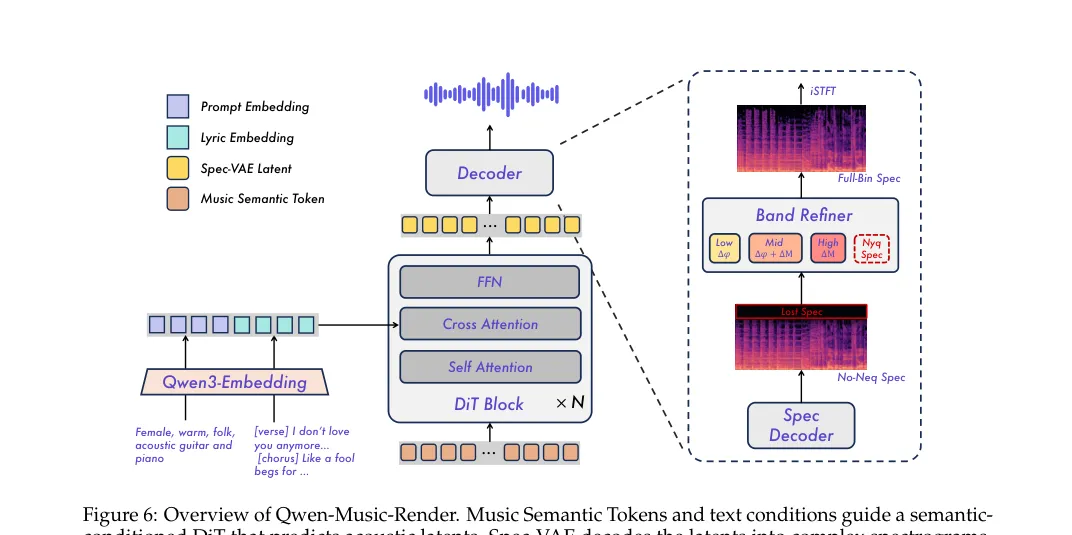
  • 1.3B、32 层 Transformer,预测连续 m=128m=128 latent。
  • Self-Attention + Cross-Attention + FFN;AdaLN 注入 timestep,CFG 使用可学习 null context。
  • DiT → Spec-VAE 复数 STFT → Band-Mode Refiner → iSTFT 48 kHz。
Full-Song FullDiT 的条件注入和整曲渲染架构
P1 · Figure 6整曲 RVQ token、歌词与 caption 共同条件化非因果 flow matching。
Qwen-Music Render 的 DiT、Spec-VAE 与 Band-Mode Refiner 架构
P2 · Figure 6DiT 之后串联 Spec-VAE 与 Band-Mode Refiner,在频谱域恢复细节。
08

Post-Training

训练策略 · 偏好对齐与强化学习

P1 · 多阶段强化

Hybrid-LM 依次经过 SFT → DPO → GRPO → OPD;OPD 以冻结 teacher 做稠密 token 蒸馏。FullDiT 使用 flow-based GRPO,EMDC 根据 pk=1Acc@1kp_k=1-\operatorname{Acc@1}_k 增强较难条件。

P2 · 课程学习 + 在线对齐

先按质量分级做课程预训练,再执行监督初始化 → 离线 DPO → 在线 GSPO;渲染 DiT 还经过预训练与无损 SFT。

09

Data Pipeline

数据规模与清洗路线

P1 · 数千万首歌

过滤去重后做风格、情绪、乐器、演唱、段落与场景的细粒度标注;依次用于预训练、风格均衡 mid-training 和高质量 SFT。渲染器只使用按带宽、立体声宽、Audiobox 与码率筛出的无损子集。

P2 · 5M+ 小时

覆盖数百语言,并以低质量到高质量的课程顺序训练;Prompt Rewriter 生成标签与歌词,渲染 DiT 使用无损 SFT 数据。
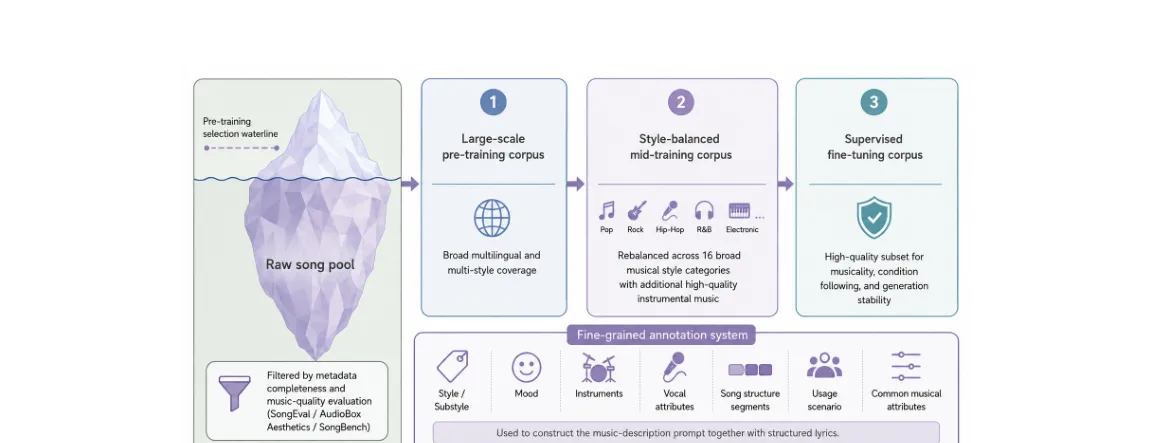
Full-Song 的数据清洗、标注与分阶段训练流水线
P1 · Figure 4数据 curation 与分阶段训练流水线。
10

Evaluation

自动指标、主观评测与榜单

P1 · Full-Song

SongBench Melody 7.20、Arrangement 7.39,多维度得分最高;Artificial Analysis 快照中 Lucky-Dolphin-Music-WQ-0618 的 Elo 为 1129,排名处于第 2–3 档。

P2 · Qwen-Music

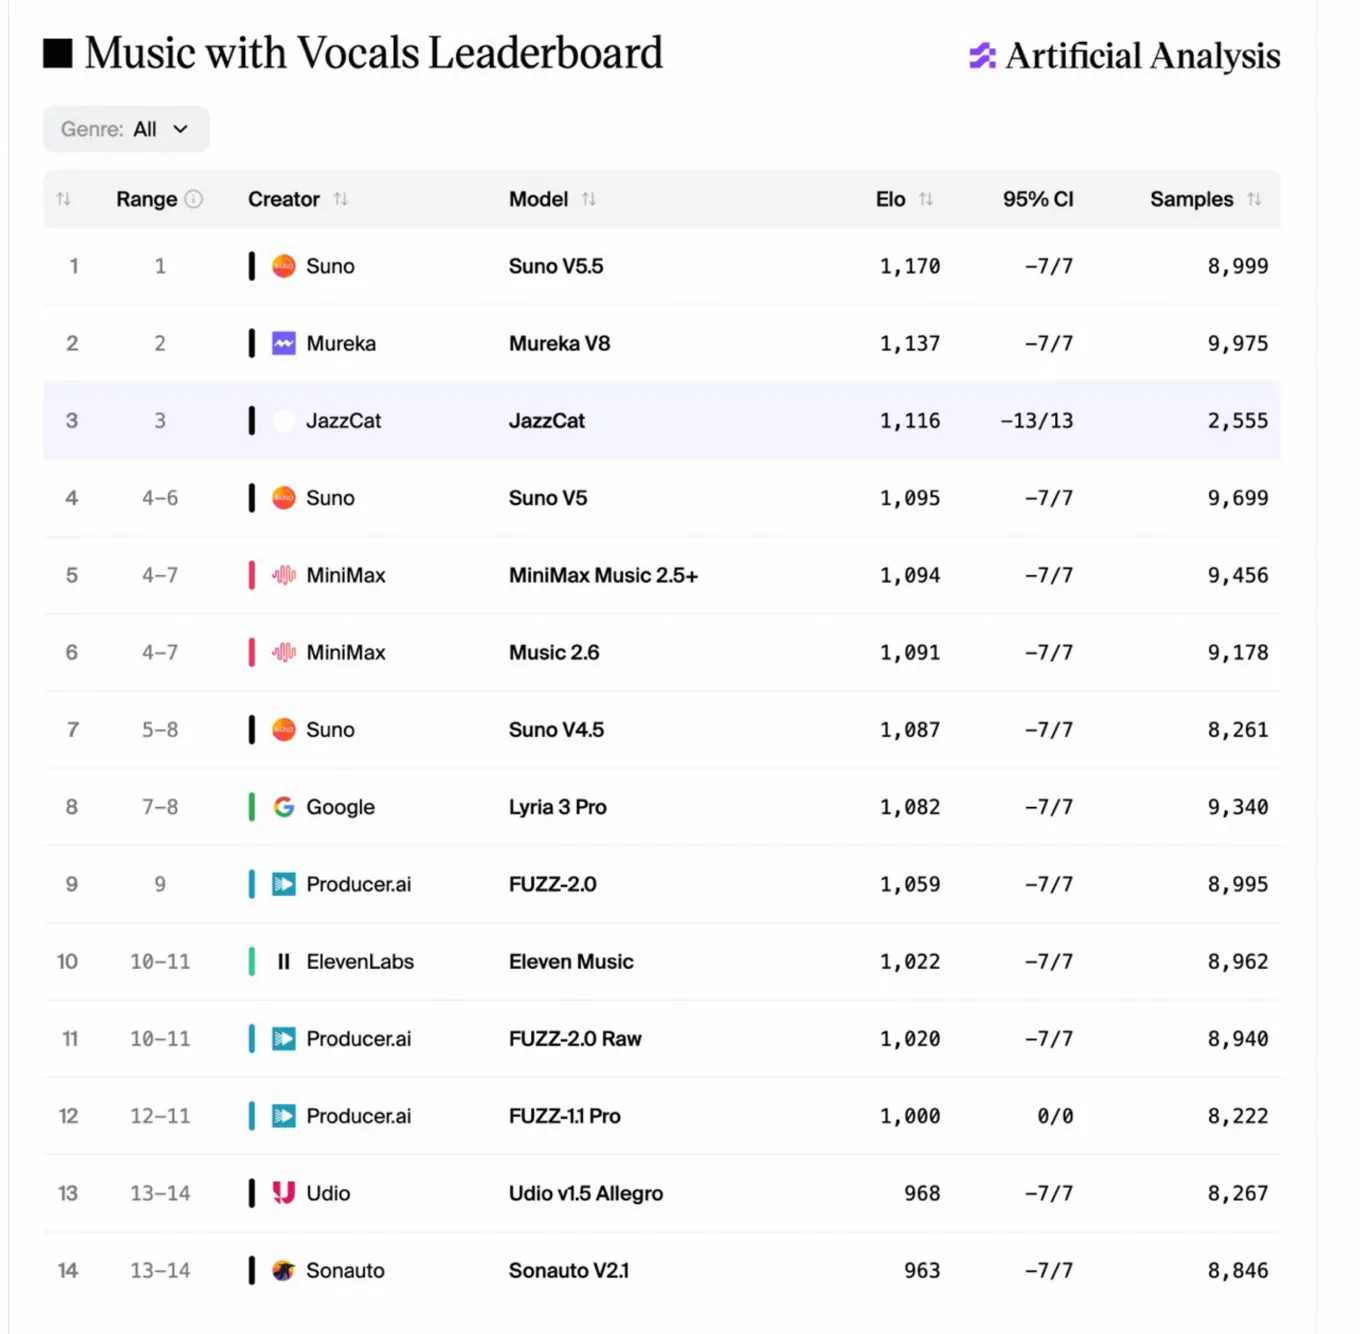
在 SongBench、SongEval 与 AudioBox 的 16 项指标中有 13 项最佳;多组 A/B 胜率为 50.3%、55.4%、58.3%、66.7% 和 59.1%;榜单中 JazzCat 排第 3。
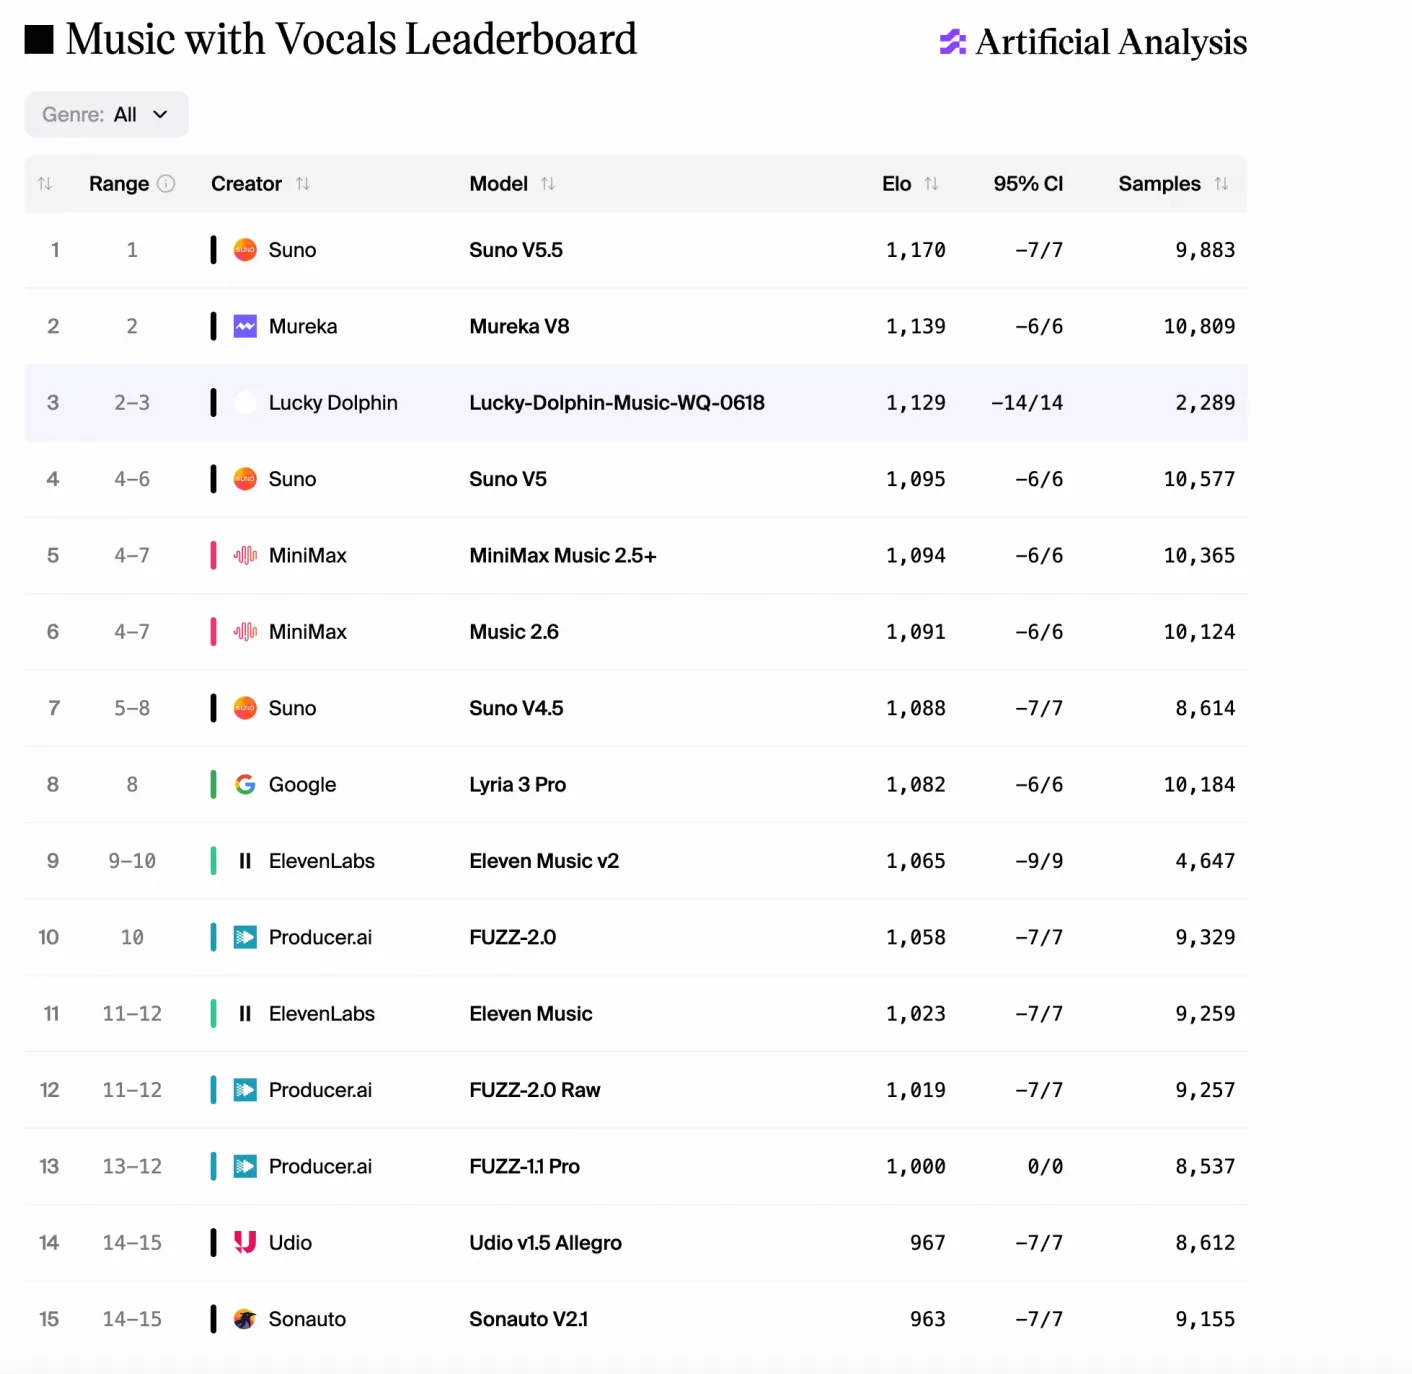
Artificial Analysis 榜单中 Lucky Dolphin 的排名截图
P1 · 榜单快照Lucky-Dolphin-Music-WQ-0618,Elo 1129;此快照中列第 3。
Artificial Analysis 榜单中 JazzCat 的排名截图
P2 · 榜单快照JazzCat,Elo 1116,英文人声音乐生成系统第 3。
11

Takeaways

结论

  1. 规模

    P1 显著更大:8B 全局 + 0.4B 局部 + 8B FullDiT;P2 更轻:0.6B tokenizer + 3B LLM + 1.3B DiT。

  2. Codebook

    P1 使用 8 × 8192 的多码本 RVQ;P2 使用 32768 规模的单码本,码率仅 375 bit/s。

  3. Melody

    P1 以 MIDI + F0F_0 两级外部条件追求细节还原;P2 以音区无关轮廓和 Melody-CoT 追求规划与改编自由。

  4. 渲染

    P1 用 8B 非因果 flow matching 保证整曲一致;P2 用 1.3B DiT + Spec-VAE / Refiner 保证频谱细节。

  5. 共同配方

    Tokenizer → LLM → flow/diffusion 渲染,加上显式旋律和偏好对齐,已经形成这一代整曲生成系统的共同技术框架。